Alig két éve még senki nem hallott róla, ma pedig egyre több ügyfél kérdezi, kell-e neki egy llms.txt fájl. A kérdés jogos, mert a téma körül két, egymásnak ellentmondó hang hallatszik. Az egyik szerint ez a következő nagy dolog az AI-korszakban, a másik szerint felesleges technikai gyakorlat, amit inkább a marketingesek ünnepelnek, mint a keresőmotorok vagy az AI-rendszerek.
A rövid válasz: egy jól dokumentált, elsődleges forrásokkal alátámasztott kép szerint az llms.txt ma egy valódi, de szűk hatókörű eszköz. Nem javítja a Google-helyezéseket, ezt a Google saját munkatársa és hivatalos útmutatója is kimondja. Arra pedig, hogy önmagában mérhetően növelné egy cég láthatóságát a ChatGPT vagy a Gemini válaszaiban, jelenleg nincs megfelelő bizonyíték: a nagy AI-szolgáltatók egyike sem dokumentálja, hogy válaszadás előtt rutinszerűen beolvasná egy tetszőleges weboldal llms.txt fájlját. Ahol viszont tényleg dolgozik, az a fejlesztői és ügynök-alapú eszközök világa, dokumentáció-központú termékeknél és API-knál. A releváns kérdés tehát nem az, hogy kell-e llms.txt, hanem az, hogy a te weboldaladnak abból a szűk, de valós használati esetből profitálna-e egyáltalán.
Ez a cikk pontosan ezt bontja ki: mi az llms.txt valójában, mit tudunk róla ténylegesen bizonyítottan, mit csak feltételezünk, és melyik cégnek éri meg egyáltalán foglalkozni vele.
Kell llms.txt a weboldaladnak 2026-ban?
Mielőtt belemennénk a részletekbe, íme a rövid válasz weboldal-típus szerint — nem helyettesíti az egyedi mérlegelést, de jó kiindulópont.
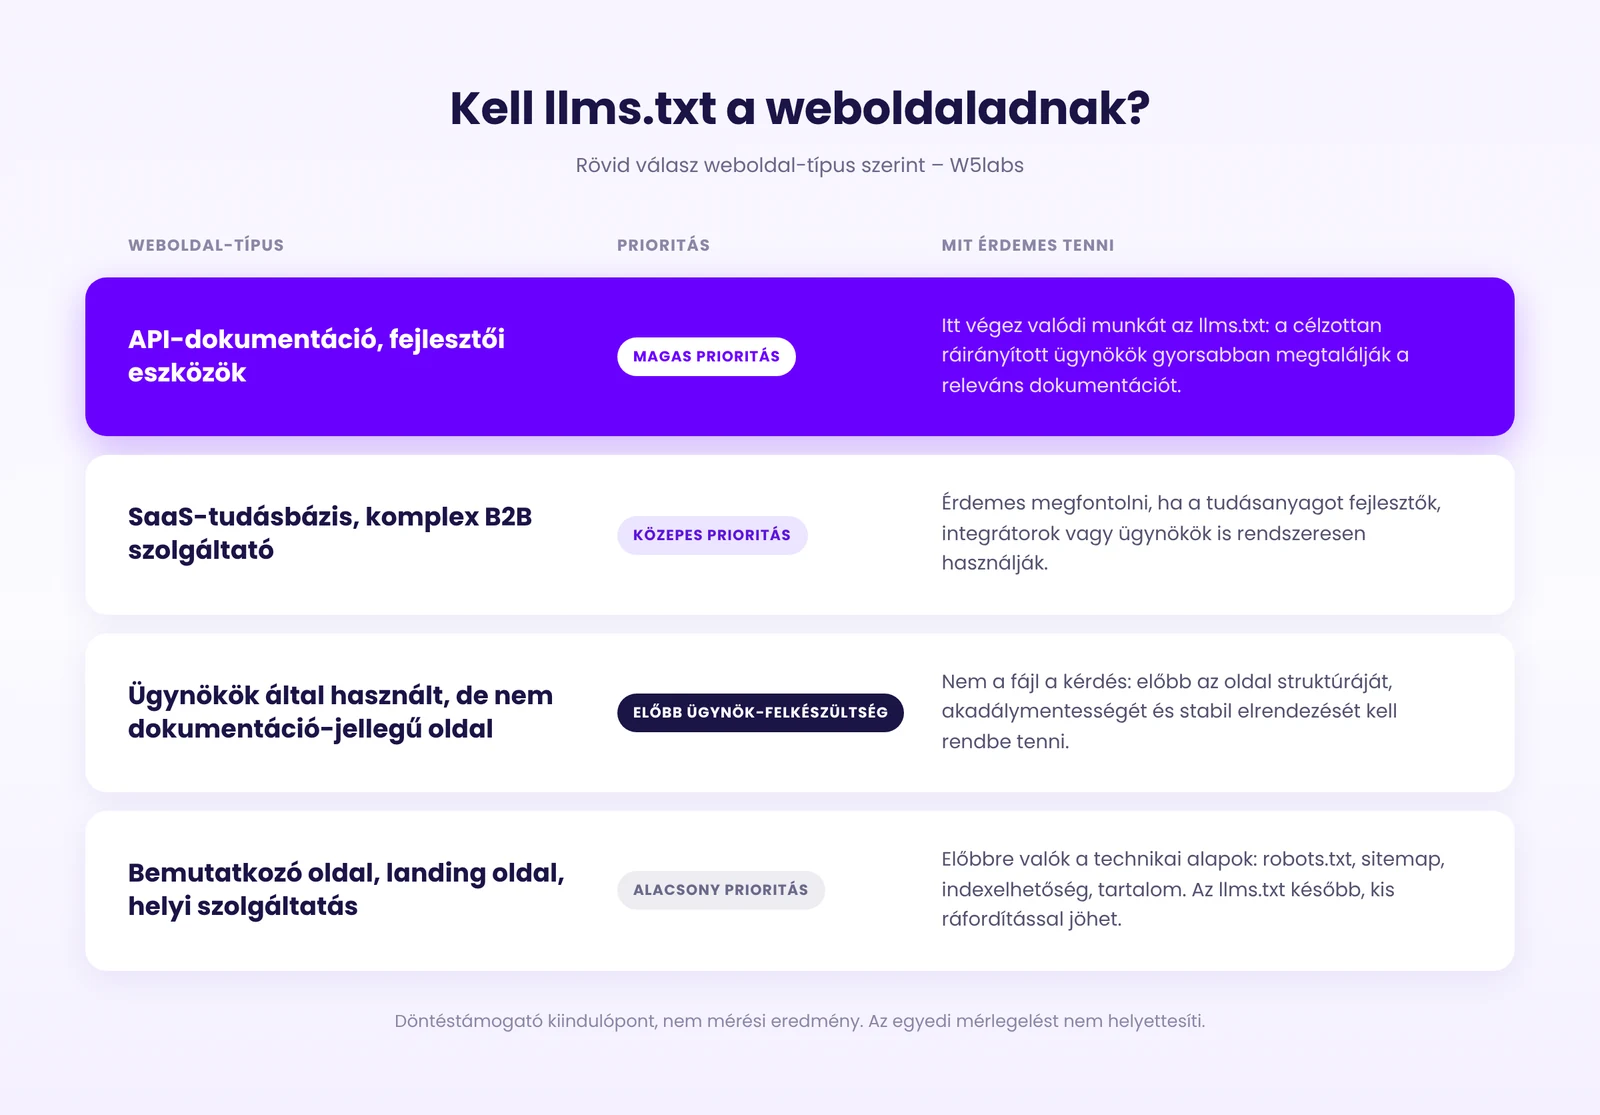
Amit ez a rangsor nem takar: a SEO-hatás nem bizonyított, az AI Visibility-hatás nem bizonyított, viszont az ügynök-felkészültségnek — vagyis annak, mennyire könnyen dolgozik egy AI-ügynök az oldal tartalmával — valódi értéke lehet, elsősorban a táblázat magasabb prioritású kategóriáiban. Hogy ez a három fogalom miért nem ugyanaz, a következő rész bontja ki.
SEO, AI Visibility és ügynök-felkészültség: három különböző dolog
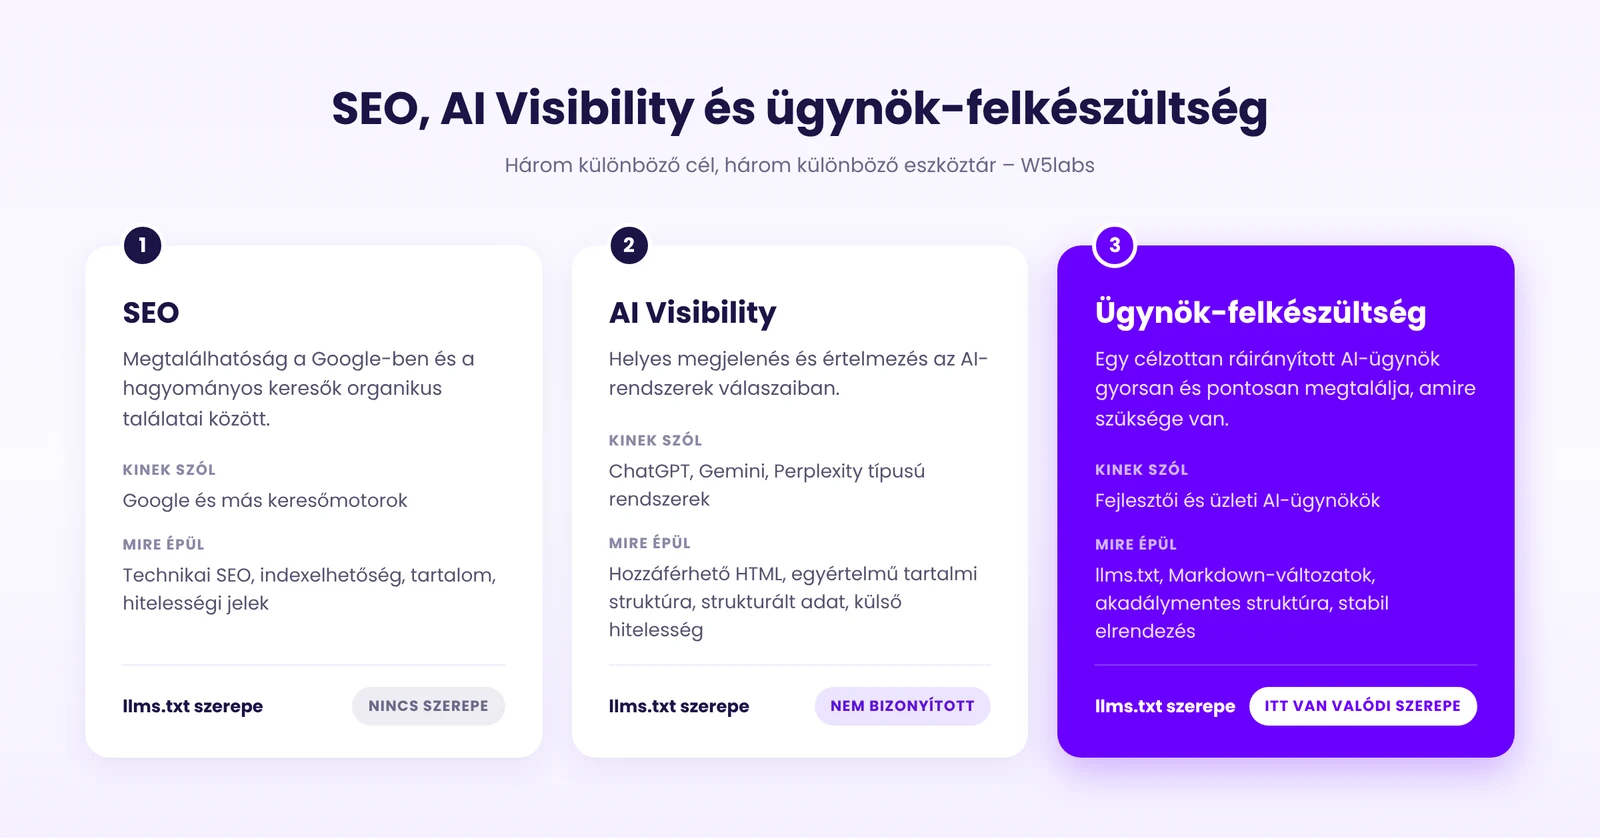
Az llms.txt körüli viták nagy része abból ered, hogy három, valójában különálló célt kevernek össze egyetlen kérdésbe: kell-e ez a fájl. Érdemes ezért élesen szétválasztani őket.
SEO: hogy egy cég megtalálható legyen a Google-ban és a hagyományos keresőmotorokban, a klasszikus organikus találatok között.
AI Visibility: hogy a cég tartalma megjelenjen, és helyesen legyen értelmezve a ChatGPT, a Gemini vagy a Perplexity típusú rendszerek válaszaiban, amikor egy felhasználó kérdez valamit.
Ügynök-felkészültség: hogy egy fejlesztői vagy üzleti AI-ügynök, amit valaki tudatosan ráirányít a cég tartalmára, gyorsan és pontosan megtalálja benne, amire szüksége van.
Ez a három cél különböző eszközöket igényel, más-más rendszerek elvárásaihoz igazodik, és az llms.txt jelenlegi ismereteink szerint elsősorban a harmadikhoz kapcsolódik érdemben.
Ezt közvetve egy friss fejlemény is alátámasztja: 2026-ban a Chrome fejlesztői csapata egy új, egyelőre kísérleti kategóriát vezetett be a Lighthouse-ba „Agentic Browsing” néven, amely azt méri, mennyire könnyen tud egy AI-ügynök dolgozni egy adott oldallal — ide tartozik a WebMCP-integráció, az akadálymentességi struktúra, az elrendezés stabilitása, és igen, az llms.txt megléte is. A kategória dokumentációja a gépi interakcióra való felépítettséget írja le: az llms.txt-audit oldala szerint fájl nélkül az ügynökök több időt tölthetnek az oldal szerkezetének feltérképezésével. A keresési rangsorolásról vagy az AI-válaszokban való megjelenésről a dokumentáció nem tesz említést, a kategóriát pedig kísérleti, javasolt szabványokra épülő funkcióként jelöli. Ez jól illeszkedik ahhoz a megkülönböztetéshez, amelyet mi is használunk: hogy egy oldal mennyire teljesít jól a keresésben, mennyire jelenik meg az AI-válaszokban, és mennyire jól dolgozható fel egy ügynök számára — az llms.txt pedig elsősorban ehhez az utóbbihoz kapcsolódik.
Aki a weboldalát valóban fel akarja készíteni a gépek és az emberek korára egyaránt, annak mindhárom réteggel foglalkoznia kell, a saját súlyuk szerint, nem pedig egyetlen technikai fájlra fókuszálva.
Mi az az llms.txt valójában, és ki találta ki
Az llms.txt egy egyszerű Markdown fájl, amelyet a weboldal gyökerében helyeznek el, jellemzően a példaoldal.hu/llms.txt címen. A fájl egy kötelező H1 címsorral kezdődik, opcionálisan egy rövid összefoglaló idézetblokkal folytatódik, majd H2 alcímek alatt listázza a weboldal legfontosabb tartalmait, linkenként egy rövid leírással. A cél, hogy egy AI-rendszer vagy AI-ügynök gyorsan megértse, mi az oldal lényege, és hol találja a legfontosabb információkat anélkül, hogy a teljes oldalstruktúrát fel kellene térképeznie.
A koncepciót Jeremy Howard vetette fel 2024 szeptemberében, azzal a gondolattal, hogy a nagy nyelvi modellek másképp dolgozzák fel a tartalmat, mint egy hagyományos keresőrobot, ezért érdemes lenne egy külön, kifejezetten nekik szánt, letisztított formátumot biztosítani. Az llms.txt tehát alapvetően ajánlás: azt mondja meg egy gépnek, mit érdemes elolvasnia, nem azt szabályozza, hogy mihez fér hozzá.
Miben különbözik a robots.txt-től és a sitemaptól
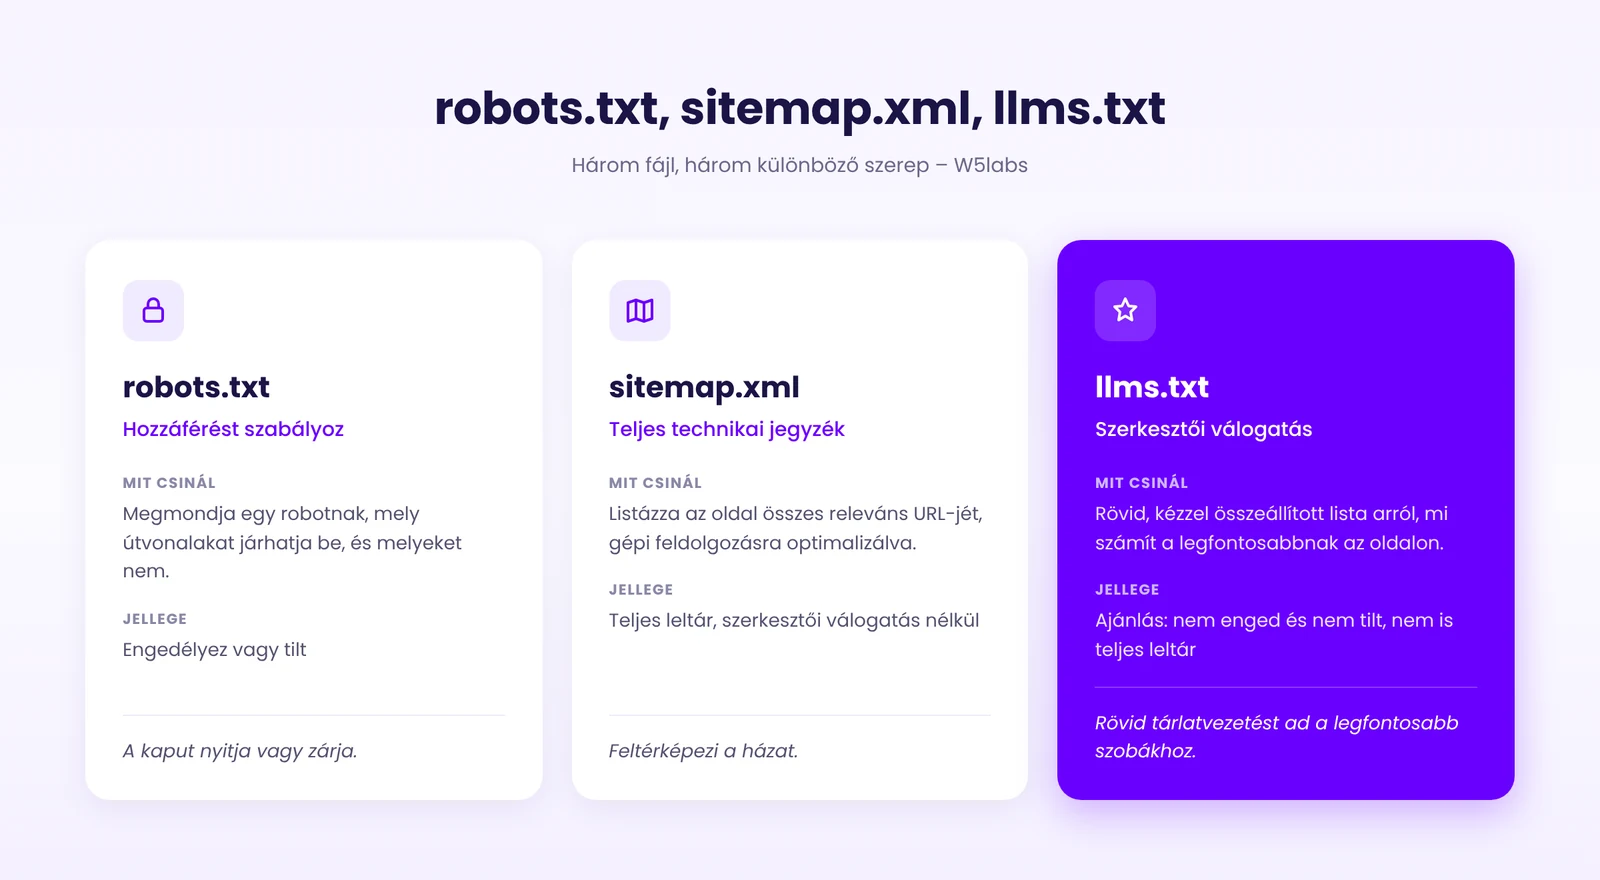
A három fájlnak három különböző szerepe van, és a gyakori félreértés pont abból ered, hogy egy kalapba szokták venni őket.
A robots.txt hozzáférést szabályoz: megmondja egy robotnak, mely útvonalakat járhatja be, és melyeket nem. A sitemap.xml egy teljes technikai jegyzék az oldal összes releváns URL-jéről, gépi feldolgozásra optimalizálva, szerkesztői válogatás nélkül. Az llms.txt ezzel szemben szerkesztői válogatás: nem hozzáférést enged vagy tilt, és nem is teljes leltár, hanem egy szűk, kézzel összeállított lista arról, mi számít a legfontosabbnak.
A robots.txt a kaput nyitja vagy zárja, a sitemap feltérképezi a házat, az llms.txt pedig egy rövid tárlatvezetést ad a legfontosabb szobákhoz.
Hivatalos szabvány, vagy csak egy közösségi konvenció
Ez az egyik legtöbbet félreértett pont, ezért érdemes a hivatalos forrásból, a llmstxt.org oldaláról idézni: a projekt saját megfogalmazása szerint ez ma is "a proposal to standardise", vagyis egy szabványosítási javaslat, nem egy elfogadott, hivatalos szabvány. Nincs mögötte szabványügyi testület, nincs kötelező érvényű specifikáció, amit a keresőmotoroknak vagy AI-cégeknek be kellene tartaniuk. A formátumot a llmstxt.org projekt és néhány, a témában érintett szereplő tartja karban, közösségi konszenzus alapján, nem hivatalos kötelezettség alapján.
Ez nem azt jelenti, hogy értéktelen. Sok jól működő webes gyakorlat épp így indult, közösségi konvencióként, majd vált idővel széles körben elfogadottá, vagy éppen marginális maradt. Az llms.txt jelenleg ebben a köztes állapotban van, és pontosan ez indokolja az óvatos, tényalapú megközelítést ahelyett, hogy bárki kritikátlanul kötelezőnek tekintené.
Mi változott az llms.txt v2-ben
2026 augusztusában jelent meg a specifikáció második változata, amelyet Jeremy Howard saját megfogalmazása szerint a két év adopciós tapasztalata alapján frissített. A v2 négy ponton módosít az eredeti, 2024-es verzión.
Először: standard link-relációkat vezet be, amelyek egy HTML `<link>` elemben vagy HTTP fejlécben segítenek egy AI-ügynöknek megtalálni egy oldal Markdown-változatát vagy a hozzá tartozó llms.txt fájlt.
Másodszor: rugalmasabbá teszi a Markdown-verziók elérési útját — az eredeti a teljes URL-hez fűzött .md kiterjesztést kívánta meg, a v2 azt is megengedi, hogy a kiterjesztés helyettesítse az eredetit.
Harmadszor: tisztázza egy almappában elhelyezett llms.txt fájl viselkedését: mindig a legspecifikusabb, saját útvonala alá tartozó fájl az irányadó. Ez azoknak fontos, akik csak egy alkönyvtár felett rendelkeznek kontrollal, például egy GitHub Pages-en futó projektdokumentációnál.
Negyedszer: elhagyja a korábbi, egy konkrét segédeszközre (llms_txt2ctx) épülő feldolgozási logikát, és általánosabban fogalmaz: az AI-ügynökök átkeresik az llms.txt-et, majd követik a releváns linkeket. Ez is mutatja, merre tart a formátum: kevésbé egy konkrét eszközhöz kötött, inkább általános konvencióvá válik.
Mit tudunk biztosan 2026-ban, és mit nem
Mivel a téma körül rengeteg félrevezető állítás kering, érdemes külön választani, mi az, amit dokumentumokkal vagy elsődleges forrással alá lehet támasztani, mi az, ami ígéretes, de még korai gyakorlat, és mi az, amire egyelőre nincs megfelelő bizonyíték.
Bizonyított, dokumentált tények. Google hivatalosan és nyíltan elutasítja, hogy az llms.txt bármilyen szerepet játszana a keresési rangsorolásban. John Mueller, a Google Search csapatának munkatársa 2026. január 20-án, egy Bluesky-bejegyzésre válaszolva, arra a kérdésre, hogy a Google saját fejlesztői oldalain található llms.txt fájl vajon a formátum elfogadását jelenti-e, ezt írta: "I'm tempted to say something snarky since this has come up so often, but to be direct, no." Vagyis kifejezett nem. Ezt a Google Search Central hivatalos, generatív AI-funkciókról szóló útmutatója is rögzíti (utolsó frissítés: 2026. július 10.): a Google Search nem használja az ilyen fájlokat, ezért létrehozásuk sem nem árt, sem nem segít a Google-beli láthatóságon és rangsoroláson. Az útmutató ugyanakkor azt is kimondja, hogy teljesen rendben van llms.txt fájlt fenntartani más szolgáltatások vagy rendszerek számára. Mueller már 2025 júniusában azt írta egy Bluesky-bejegyzésben, hogy jelenleg egyetlen AI-rendszer sem használja az llms.txt-t. Emellett egy 2026 júniusában közzétett Ahrefs-elemzés, amely 137 210 domain 2026. májusi forgalmi és botforgalmi adatait vizsgálta, azt találta, hogy a vizsgált oldalak 28 százaléka publikál llms.txt fájlt, ám ezeknek 97 százaléka egyetlen látogatást sem kapott a vizsgált hónapban. Ahol mégis érkezett kérés a fájlra, ott a forgalom 96 százaléka botoktól származott, és az összes AI-jellegű bot együttesen is csak a kérések 19,5 százalékát adta, ezen belül a kifejezetten válaszadási célú, tartalom-visszakereső AI-botok pedig az összes kérés mindössze 1,1 százalékát. A kutatás azt is rögzítette, hogy egyetlen AI-bot sem próbált llms.txt fájlt keresni olyan oldalakon, ahol az egyáltalán nem létezett, vagyis a fájl proaktív, automatikus keresése ma nem jellemző viselkedés.
Fontos kontextus, hogy az Ahrefs mintája nem egy véletlenszerű keresztmetszet: eleve technikailag aktívabb, SEO-tudatosabb domainek felé torzít, ami felfelé húzhatja az elterjedtségi arányt: maga az Ahrefs is felső korlátnak tekinti a 28 százalékos értéket. Ezt jól mutatja a Rankability 2026. szeptember 18-i mérése, amely a Tranco lista alapján vizsgálta a legnépszerűbb domainek gyökérfájljait: a top 1000 oldal 9,3, a top 10 000 oldal 8,3 százaléka szolgál ki érvényes llms.txt vagy llms-full.txt fájlt — vagyis egy szélesebb, nem eleve SEO-tudatos mintán az arány jóval alacsonyabb, mint az Ahrefs-mintában. Iparági bontásban az utazási (16,0 százalék) és a pénzügyi szolgáltatások (15,4 százalék) kategória vezet, a technológiai szektor 6,4 százalékon áll. A Rankability korábbi, júniusi mérése a top 1000 oldalnál 8,7 százalékot talált, de a mintavétel és az érvényesítés módszere azóta változott, ezért a két adat nem hasonlítható össze közvetlenül.
Kialakuló gyakorlat, ígéretes irány. Egyre több dokumentáció-generáló platform, tipikusan fejlesztői eszközöket kiszolgáló oldalak, automatikusan előállít llms.txt fájlt a saját dokumentációjához, és kialakulóban van egy külön eszközkategória is, amely llms.txt-szerű, letisztított dokumentációt tesz elérhetővé kódoló AI-ügynökök számára, jellemzően MCP-alapú integrációkon keresztül. Ez a gyakorlat valós és növekvő, de eszközfüggő: nem minden fejlesztői környezet olvassa be automatikusan, tudatos beállítást vagy külön kiegészítőt igényel.
Amire egyelőre nincs megfelelő bizonyíték. Nincs dokumentált, elsődleges forrással alátámasztható adat arra, hogy az llms.txt megléte önmagában növelné, hogy egy céget gyakrabban idézzen a ChatGPT, a Gemini, a Perplexity vagy a Claude a válaszaiban. Nincs olyan hivatalos nyilatkozat sem az OpenAI, sem a Google, sem az Anthropic részéről, amely szerint a saját rendszereik rutinszerűen beolvasnák egy tetszőleges harmadik fél llms.txt fájlját válaszadás előtt. Ami dokumentált: mindhárom cég publikál llms.txt fájlt a saját fejlesztői dokumentációjához (OpenAI, Anthropic, Google) — ez azt mutatja, hogy felkínálják a formátumot az őket használó fejlesztőknek, nem azt, hogy a kereső- vagy válaszadó rendszereik automatikusan beolvasnák mások llms.txt fájljait.
AI-tanulás, AI-keresés és AI-ügynökök: miért nem ugyanaz a három
A fenti hármas felosztás mögött egy technikai ok is áll: az AI-rendszerek három, egymástól nagyon különböző módon találkoznak egy weboldal tartalmával.
Az első a modellek betanítása, amely hatalmas, előre összegyűjtött adathalmazokon történik, jóval a felhasználói kérdés elhangzása előtt — erre egy webhely gyökerében elhelyezett fájl gyakorlatilag semmilyen hatással nincs.
A második a válaszadás pillanatában futó keresés és visszakeresés, amikor egy ChatGPT, Gemini vagy Perplexity valós időben von be webes találatokat. Itt a technikai hozzáférhetőség, a jól felépített HTML, az egyértelmű tartalmi struktúra és a technikai SEO teremt alapot, és ahol, a fentebb idézett adatok szerint, az llms.txt szerepe ma elhanyagolható.
A harmadik a fejlesztői és üzleti AI-ügynökök világa: olyan eszközök, amelyeket egy ember konkrét feladatra indít el, explicit módon, egy megadott URL vagy integráció mentén. Ez az a réteg, ahol az llms.txt ténylegesen hasznos lehet, mert itt nem automatikus, tömeges crawlelésről van szó, hanem célzott, emberi kezdeményezésre induló lekérdezésről.
Ez a három réteg más-más mértékben reagál egy llms.txt fájlra, és aki ezt nem választja szét, az könnyen von le téves következtetést a formátum hasznosságáról bármelyik irányban.
Kinek éri meg foglalkozni vele: a W5labs döntési mátrixa
Ahelyett, hogy általánosan mondanánk igent vagy nemet, két szempont mentén vizsgálunk meg egy adott weboldalt. Ezt a keretet W5labs llms.txt Priority Matrix néven használjuk.
Az első tengely az, hogy a tartalom mennyire dokumentáció- vagy API-jellegű: van-e olyan strukturált, ismétlődően használt tudásanyag, amit fejlesztők, integrátorok vagy AI-ügynökök rendszeresen felkeresnek. A második tengely az, hogy az üzleti modell mennyire épít az AI-ügynökök általi közvetlen, ismétlődő tartalom-felhasználásra, szemben azzal, hogy a látogatók túlnyomó többsége ember, hagyományos keresésen vagy közvetlen látogatáson keresztül érkezik.
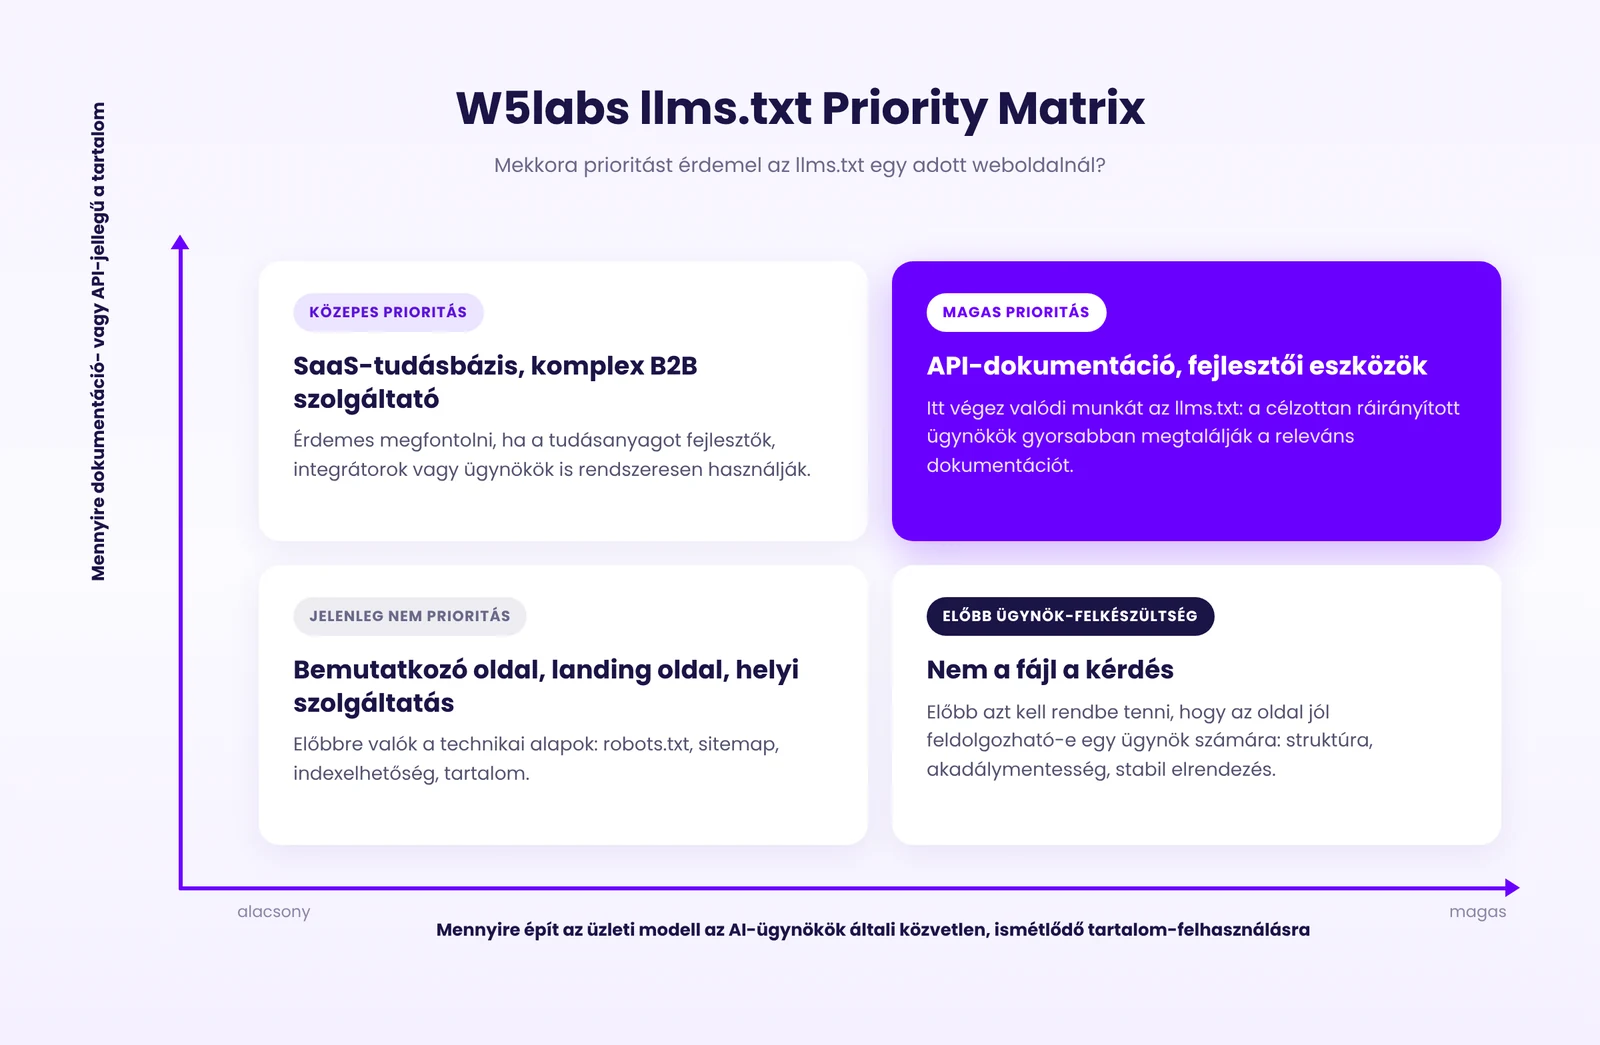
A mátrix a cikk elején látott rangsort két tengelyre bontja: az API-dokumentáció és a fejlesztői eszközök jellemzően a jobb felső negyedbe esnek, a hagyományos bemutatkozó és landing oldalak pedig a bal alsóba. A jobb alsó negyed külön figyelmet érdemel: ott nem a fájl a kérdés, hanem az, hogy az oldal egyáltalán jól dolgozható-e fel egy ügynök számára. A keret döntéstámogató eszköz, nem mérési eredmény, és nem helyettesíti az egyedi mérlegelést, de jó kiindulópont ahhoz, hogy egy cég reálisan lássa, a saját helyzetében mekkora tétje van a kérdésnek.
Mit tartalmazzon egy jó llms.txt fájl
A jó llms.txt rövid, letisztult Markdown fájl: egy tömör bemutatkozás a cégről vagy termékről, majd egy-egy soros leírással ellátott linkek a legfontosabb tartalmakhoz.
Rossz gyakorlat, amikor egy cég egyszerűen bemásolja a teljes navigációs menüjét leírás nélkül, így egy hosszú, kontextus nélküli linklista születik, amelyből egy AI-ügynök éppúgy nem tudja megállapítani, mi számít fontosnak, mintha egyáltalán nem lenne fájl.
Jó gyakorlat, amikor a fájl tudatos válogatás, néhány valóban releváns oldalra, tömör és konkrét leírással, amely önmagában is elmondja, mit talál ott egy olvasó.
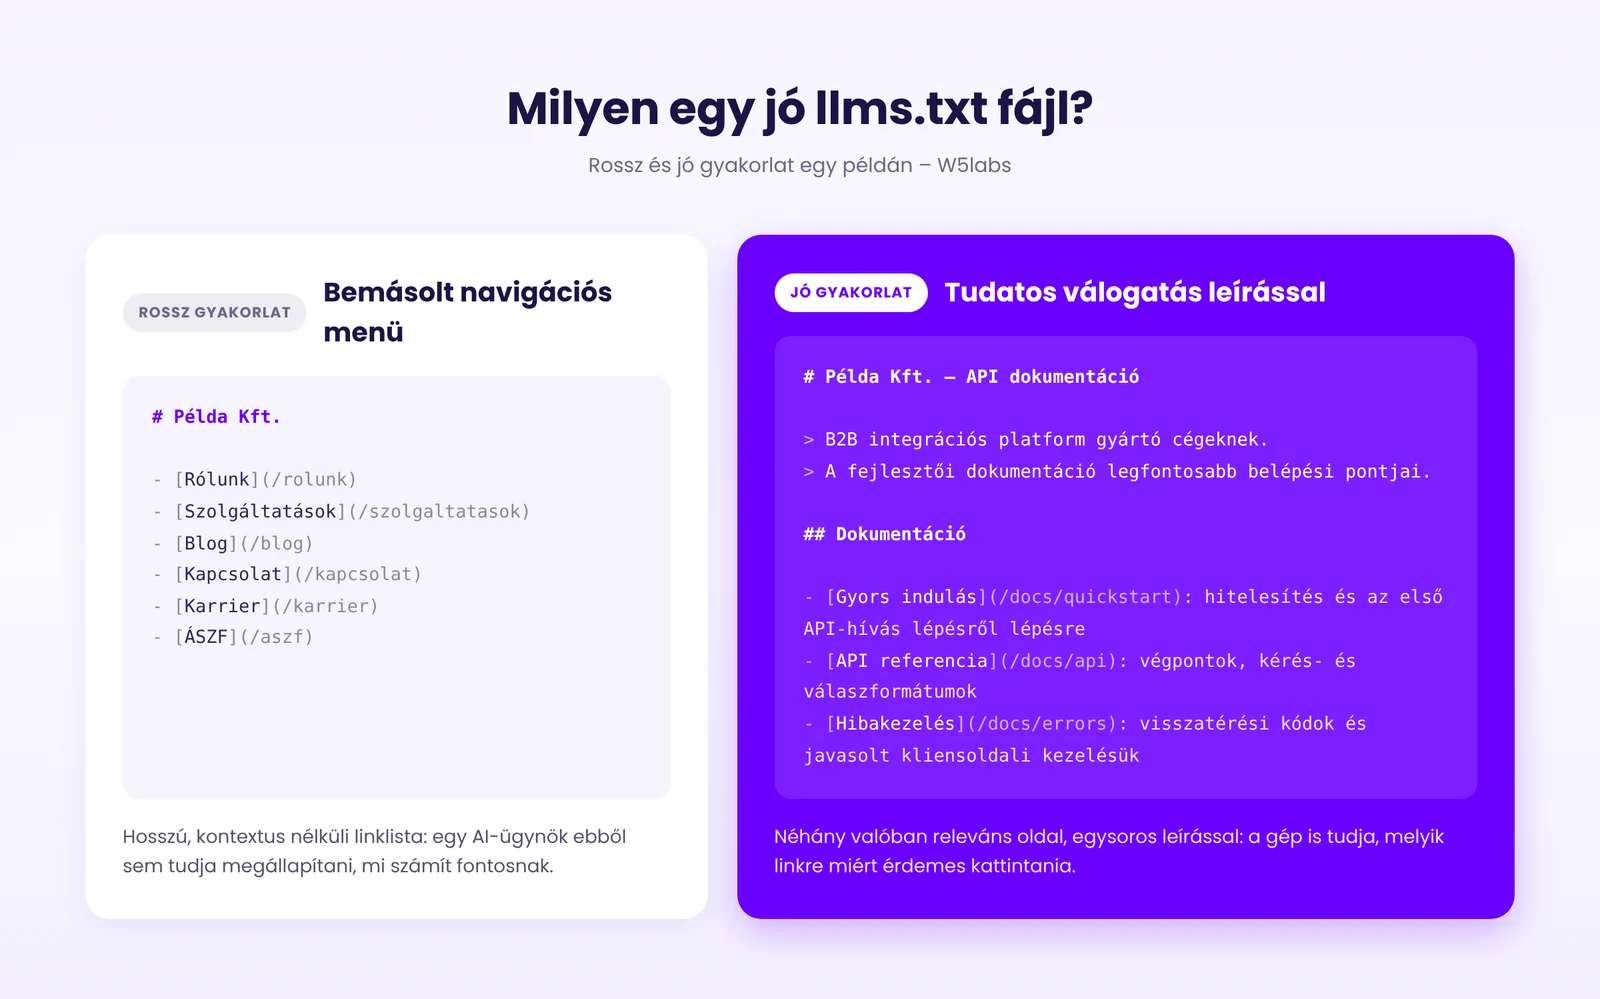
A különbség nem a fájl hosszában van, hanem abban, hogy a második esetben egy gép is pontosan tudja, melyik linkre miért érdemes kattintania.
Tipikus hibák
A leggyakoribb hiba, amikor egy cég a marketingszövegét másolja be az llms.txt-be tényszerű, tömör leírások helyett. A második az elavult tartalom: a fájl elkészül, majd évekig nem frissül, miközben az oldal szerkezete változik és a linkek egy része érvénytelenné válik. A harmadik a túlzott elvárás: rövid távú, mérhető SEO- vagy AI-láthatósági javulást várnak tőle, majd csalódnak, amikor ez elmarad, holott — mint fentebb látszik — erre a fájl önmagában nem alkalmas. A negyedik, amikor a cég az llms.txt-re helyezi a hangsúlyt, miközben a robots.txt és a sitemap.xml karbantartása elmarad, pedig ezek a technikai alapok szempontjából lényegesen nagyobb súlyt képviselnek.
Az llms.txt nem GEO-stratégia, csak egy technikai elem benne: a W5labs megközelítése
Fontos tisztán látni: az llms.txt önmagában nem AI Visibility-stratégia, és nem is helyettesíti azt. Egy fájl a gyökérkönyvtárban nem old meg olyan kérdéseket, mint a tartalom mélysége, a strukturált adat helyes használata, az oldal technikai indexelhetősége vagy a cég külső hitelességi jelei. Legfeljebb egy kiegészítő, esetenként hasznos réteg egy sokkal szélesebb munkában.
Ezért nálunk az llms.txt kérdése nem önálló technikai projektként, és nem is a technikai SEO-nál indul. A Strategy → Creative → Development → Support modellünkben a Strategy szakasz méri fel a jelenlegi helyzetet: a cég üzleti célját, a SEO- és AI Visibility/GEO állapotát, és ez alapján határozza meg a prioritásokat. Ehhez a saját mérési keretünket, a GVS-t (Growth Visibility Score) használjuk — ez segít számszerűsíteni a jelenlegi helyzetet és azonosítani a legfontosabb hiányosságokat és lehetőségeket, ezek alapján pedig meghatározható, hogy az llms.txt mekkora prioritást érdemel az adott vállalatnál.
Az így kialakuló feladatok kerülnek aztán a modell további szakaszaira: az indexelhetőség, a strukturált adat, a tartalom mélysége vagy a külső hitelességi jelek erősítése a Creative és a Development közös munkája, az llms.txt technikai megvalósítása konkrétan Development feladat, az ellenőrzése és karbantartása pedig a folyamatos Support része. Az viszont, hogy egyáltalán szükséges-e és milyen prioritással, Strategy kérdés marad.
Mi azt szoktuk mondani, hogy nem minden újdonságot kell azonnal bevezetni, csak azért, mert lehet.
Mit tesztelünk most, és miért nem mondunk többet ennél
A W5labs jelenleg egy saját, hosszabb távú megfigyelést készít elő, amelyben néhány kontrollált esetben vizsgáljuk majd, hogyan viselkedik valós forgalmi adatokon egy gondosan felépített llms.txt fájl. A megfigyelésben azt követjük, milyen gyakran és mely botok kérik le az llms.txt fájlt és az abban hivatkozott oldalakat, hogyan oszlik meg ez a forgalom a válaszadási célú AI-botok, a tanítási célú crawlerek és a fejlesztői ügynökök között, és hogy egy célzott ügynöki feladatnál gyorsabban vagy pontosabban jut-e el egy ügynök a keresett információhoz a fájllal, mint nélküle. Ezzel párhuzamosan a GVS-mérésünkben figyeljük a vizsgált oldalak AI-említéseit és Share of AI Voice-értékét, olyan kontrolloldalakkal összevetve, amelyeken nincs llms.txt. Ez a munka most áll össze, eredményei még nincsenek, ezért ezen a ponton szándékosan nem állítunk semmit a saját méréseinkre hivatkozva. Amint lesz elég adatunk ahhoz, hogy felelősséggel be tudjunk számolni róla, azt egy külön cikkben osztjuk majd meg.
Az llms.txt valódi, de ma még korlátozott hatókörű eszköz. Nem hivatalos szabvány, hanem egy folyamatosan fejlődő közösségi javaslat, amelynek második változata 2026 augusztusában jelent meg. A klasszikus SEO-ban dokumentáltan nincs szerepe, ezt Google is megerősítette. A konzumer AI-keresésben és -válaszadásban a jelenlegi adatok szerint minimális a ténylegesen mérhető hatása. Ahol viszont valós hasznot hoz, az a fejlesztői eszközök és AI-ügynökök célzott, tudatos használata, elsősorban dokumentáció-központú termékeknél és API-knál. Ez azt jelenti, hogy a legtöbb cégnek nem kell most azonnal nekiugrania, ugyanakkor egy meghatározott körnek, a saját tartalmának és üzleti modelljének megfelelően, valóban megéri a befektetés.