Machine Experience: hogyan értelmezik a weboldaladat a gépek és az AI-rendszerek?
A machine experience (MX) azt írja le, mennyire pontosan képes egy automatizált rendszer egy weboldal tartalmát, szerkezetét, entitásait, kapcsolatait és bizonyítékait feltérképezni és értelmezni. Míg a UX az emberi használhatóságot optimalizálja, az MX a gépi értelmezhetőséget.
2026 júniusában a Cloudflare Radar nyilvános irányítópultja azt mutatta, hogy a Cloudflare hálózatán átmenő, weboldalakhoz érkező HTTP kérések körülbelül 57 százaléka már automatizált rendszertől származik, nem embertől. Ezt Matthew Prince, a Cloudflare vezérigazgatója erősítette meg egy X-bejegyzésben 2026. június 3-án, hozzátéve, hogy a pontos fordulónap nehezen határozható meg, mert az adat kissé zajos, a tendencia iránya viszont egyértelmű. Fontos pontosítás, hogy ez a szám a Cloudflare saját hálózatának forgalmát méri, nem a teljes internetet, önálló, auditált Cloudflare-közlemény helyett egy vezérigazgatói megfigyelésről van szó, és nem kizárólag AI-forgalom, jelentős részét hagyományos keresőrobotok és egyéb automatizált rendszerek adják. Prince ezt olyan fordulópontként értelmezte, amikor a Cloudflare hálózatán az automatizált forgalom aránya meghaladta a humán forgalomét.
Ez az egyetlen szám átrendezi, hogyan érdemes gondolkodni egy weboldalról. Ebből a változásból erősödik fel a machine experience szemlélete: hogyan tervezzünk weboldalt akkor, amikor azt már nemcsak emberek, hanem automatizált rendszerek és AI-asszisztensek is olvassák és értelmezik.
A machine experience nem új SEO-trükk, hanem új olvasói nézőpont.
Mit jelent a machine experience a gyakorlatban?
A felhasználói élmény, vagyis a UX azt vizsgálja, hogy egy ember gyorsan eligazodik-e egy oldalon, megbízik-e benne és látja-e, mi a következő lépés. A machine experience ugyanezt a kérdést teszi fel egy gép szemszögéből. Hogyan tudja egy rendszer megbízhatóan olvasni a weboldal szerkezetét, jelentését és hitelességét.
Egy egyszerű képpel élve a weboldal olyan, mint egy üzlethelyiség. Az ember a kirakatot nézi, a gép az alaprajzot olvassa. A kettő ugyanarról az épületről szól, mégis teljesen más nyelven beszél, és ma már mindkét olvasót ki kell szolgálni.
A machine experience elsőre technikai kérdésnek tűnik, valójában üzleti döntés. Amikor egy AI-asszisztens szolgáltatókat hasonlít össze egy felhasználó helyett, jellemzően azonosítható jeleket használ a döntéshez, bár a pontos működés szolgáltatónként eltérő és nem minden részletében nyilvános. Amit biztosan tudunk, hogy az egyértelmű szolgáltatásleírás, a jól azonosítható entitások, a strukturált információ és az alátámasztható állítások egyaránt javítják a webes tartalom gépi értelmezhetőségét. Egy weboldal lehet vizuálisan modern és közben gyenge egy gép számára, ahogy fordítva is igaz, egy technikailag makulátlan oldal is hathat hidegnek egy ember szemével nézve.
Miben más a machine experience, mint a UX, a SEO és az AI Visibility?
A négy fogalom gyakran összemosódik, pedig más-más kérdésre válaszol.
UX, vagyis felhasználói élmény: mennyire használható és érthető a weboldal egy ember számára.
SEO, vagyis keresőoptimalizálás: mennyire feltérképezhető, indexelhető és látható a weboldal a keresőmotorokban.
AI Visibility: mennyire és milyen pontossággal jelenik meg a márka vagy egy adott tartalom AI-rendszerek által generált válaszokban.
Machine Experience: mennyire megbízhatóan értelmezhető a teljes digitális jelenlét automatizált rendszerek számára, a szolgáltatásarchitektúrától a technikai alapokig.
A négy egymásra épül, nem helyettesíti egymást. Egy leegyszerűsített szemléleti modellként így gondolkodhatunk róla: Machine Experience → Understanding → Retrieval → AI Visibility → Recommendation. A jó machine experience növeli annak esélyét, hogy egy rendszer pontosan értelmezze és megfelelő kontextusban használja fel a weboldal információit, ez azonban önmagában nem garantál AI-megjelenést vagy ajánlást. Az AI Visibility tehát nem a machine experience másik neve, hanem az egyik lehetséges, mérhető következménye.
A UX azt tervezi meg, amit az ember használ. A Machine Experience azt, amit a gép értelmezni tud.
Miért nem elég ma már a hagyományos SEO
Sok B2B weboldal még mindig egy régebbi útvonalra épül. Valaki rákeres valamire a Google-ben, megnyit három találatot, elolvas egy kicsit belőlük és kitölt egy űrlapot. Ez az útvonal még létezik, de már régen nem az egyetlen.
Ma az első szűrés gyakran még a kattintás előtt lezajlik. Egy döntéshozó megkérdez egy AI-rendszert, milyen megoldások jöhetnek szóba. Egy kolléga egy asszisztensre bízza a beszállítók összehasonlítását. Egy böngészőbe épített ügynök összefoglalja az oldalakat helyette. Egy beszerzési munkafolyamat automatikusan kigyűjti a kritériumokat a weboldalakról. Ezekben a helyzetekben a weboldalt jellemzően nem úgy olvassák, ahogy egy ember olvasná, hanem adatként, szerkezetként és bizonyítékként értelmezik.
Ha a szolgáltatásarchitektúra, az oldalszerepek vagy a bizonyítékok rétege hiányzik, a weboldal nem feltétlenül veszít azonnal forgalmat. Valami ennél veszélyesebbet veszít el, a besorolást. A rendszerek könnyen lehet, hogy nem értik meg, miért releváns az ajánlatod, egyáltalán nem említenek, rosszul írnak le, vagy egy olyan általános kategóriába sorolnak, ahol minden szereplő ugyanúgy hangzik.
A gyenge szerkezet nem csak a gépeknek nehéz, hanem az embereknek is. Egy zavaros weboldal a látogatóra hárítja a munkát, hiszen neki kell kitalálnia, mit is csinál valójában a cég és mi történik, ha felveszi vele a kapcsolatot.
Nem a forgalmadat veszíted el először, hanem a besorolásodat.
A W5labs Machine Experience-modellje: Identity, Structure, Evidence, Accessibility
Így gondolkodunk a modern weboldalakról. Ezt a szemléletet W5labs Machine Experience Frameworknek nevezzük, négy réteget vizsgál, amikor egy weboldal gépi értelmezhetőségét mérjük fel, ezek egymásra épülnek, és mind a négy szükséges ahhoz, hogy egy automatizált rendszer megbízhatóan tudja értelmezni, mit kínál egy cég.
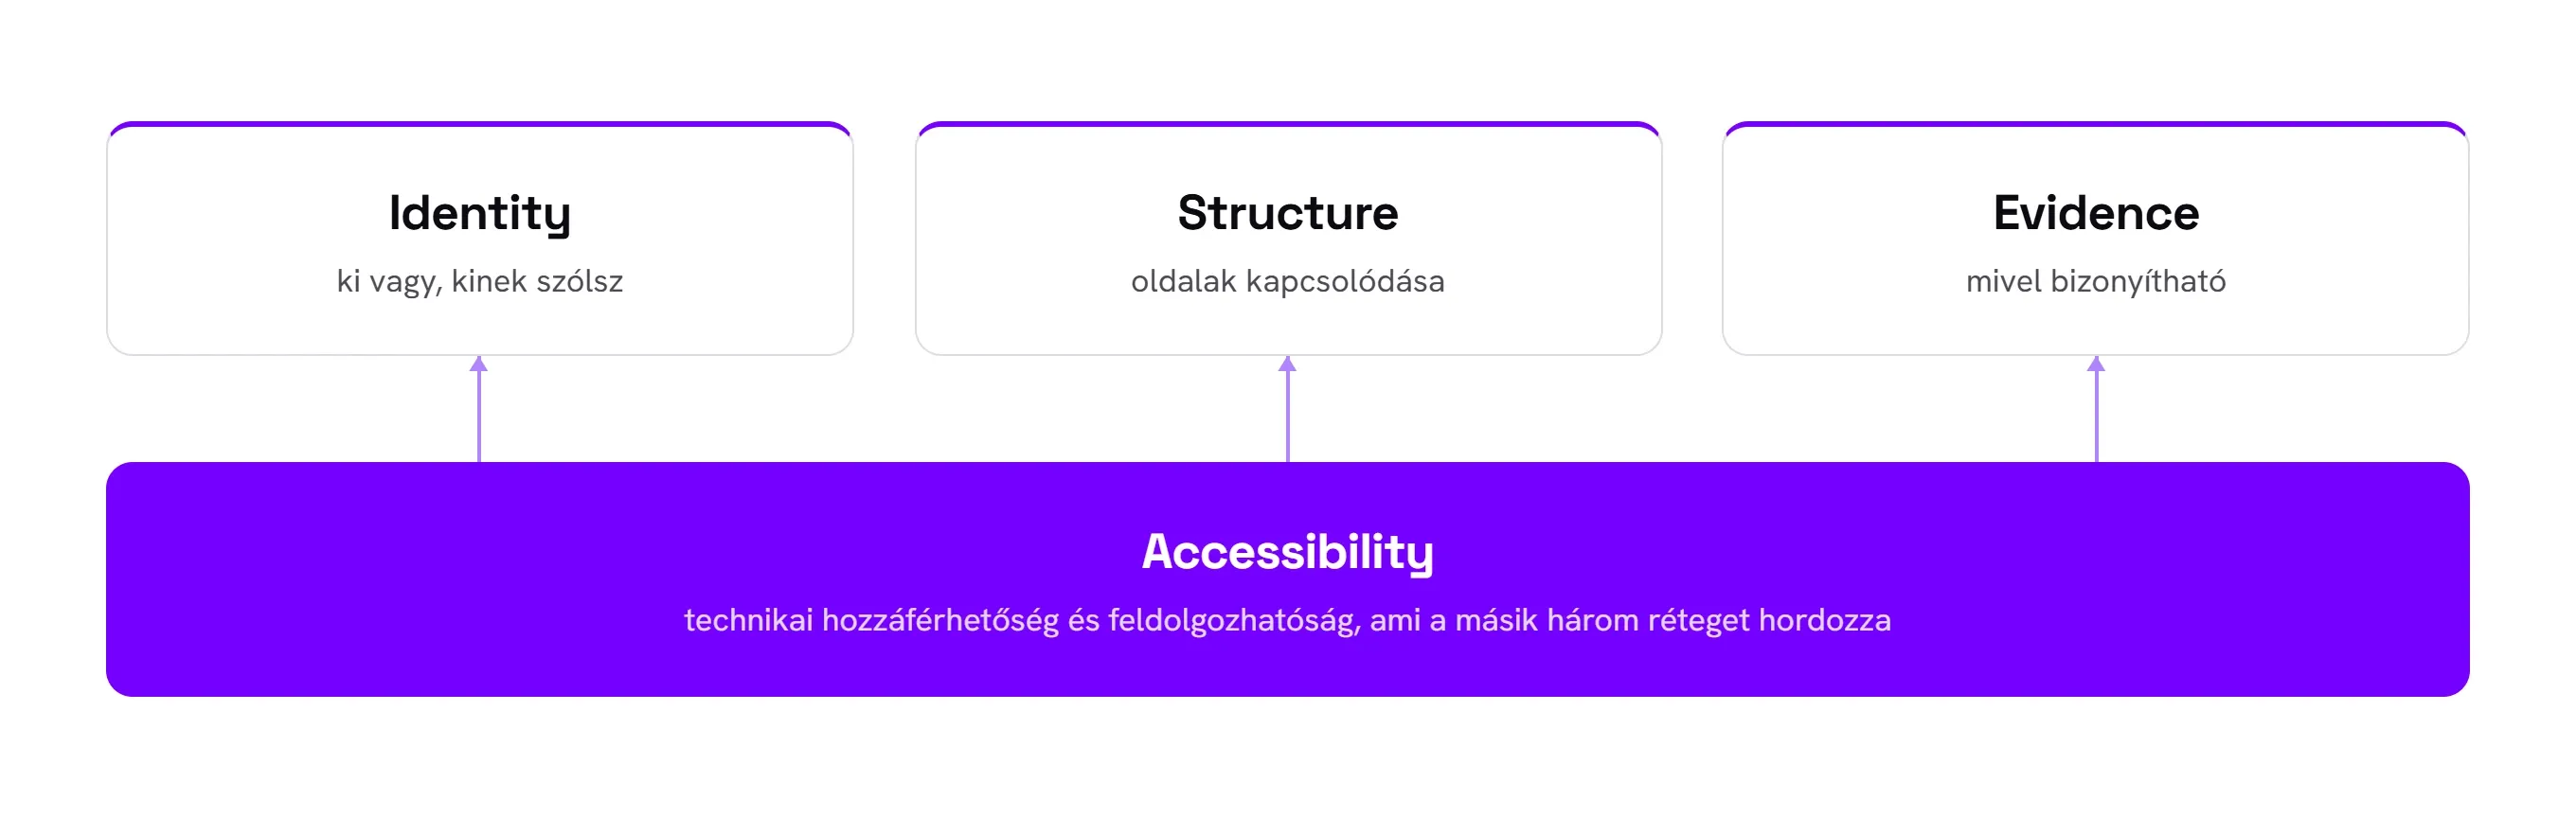
Identity
Kérdés: Érthető-e egyértelműen, ki a cég, mit kínál, kinek és milyen helyzetben?
Válasz: Egy erős weboldal nem elégszik meg annyival, hogy „webfejlesztés" vagy „digitalizáció", hanem elmagyarázza, milyen problémákat old meg, milyen helyzetekhez illik az ajánlat és hol vannak a határai.
Rossz példa: „Komplex digitális megoldásokat kínálunk minden iparág számára." Ez a mondat sem embernek, sem gépnek nem mond semmit, mert nincs benne probléma, célcsoport és határ.
Jó példa: „Többnyelvű WordPress oldalakat építünk gyártó és B2B cégeknek, amikor a meglévő weboldal már nem szolgálja ki a nemzetközi értékesítést." Ebből egy gép kategóriát, célcsoportot és helyzetet olvas ki, egy döntéshozó pedig azonnal látja, róla szól-e.
A gép azt tudja pontosan besorolni, amit a cég pontosan meg tud fogalmazni.
Structure
Kérdés: Érthető-e az információarchitektúra és az egyes oldalak közötti kapcsolat?
Válasz: A főoldal, a szolgáltatásoldalak, a blogbejegyzések, az esettanulmányok és a kapcsolati oldal nem ismételhetik ugyanazt az általános szöveget, mindegyiknek saját szerepe van a döntési folyamatban. Emellett legyen világos kapcsolat a probléma, az ajánlat, a bizonyíték és a következő lépés között, zsákutcák nélkül.
Rossz példa: A blogbejegyzés, a szolgáltatásoldal és a kapcsolati oldal ugyanazt az általános bemutatkozó szöveget ismétli, csak más címmel, és az olvasó a cikk végén nem tudja, mi legyen a következő lépése.
Jó példa: A blogbejegyzés egy konkrét problémát jár körül és egy releváns szolgáltatásoldalra vezet tovább, a szolgáltatásoldal az ajánlatot teszi eldönthetővé, a kapcsolati oldal pedig egyetlen egyszerű lépésre redukálja a következő teendőt.
Egy tiszta oldalszerep-felosztás egyszerre segíti a crawlert a besorolásban és az embert a tájékozódásban.
Evidence
Kérdés: Ellenőrizhetők és bizonyíthatók-e a weboldalon szereplő állítások?
Válasz: Az, hogy „megbízhatóak vagyunk", önmagában nem bizonyíték. Egy pontos leírás arról, hogyan dolgozol, átlátható kompromisszumok, érthető technikai döntések és hivatkozott források sokkal erősebben hatnak.
Rossz bizonyíték: „Több éves tapasztalattal megbízható digitális partnerként támogatjuk ügyfeleinket."
Jobb bizonyíték: „Az új weboldalt öt országra, több nyelvre és közel 500 aloldal kezelésére terveztük."
Evidence-nek jellemzően az alábbiak számítanak: konkrét esettanulmány, mérhető projektadat, ügyfélreferencia, szakmai forrás, a szerző vagy szakértő egyértelmű feltüntetése, dátum és frissítési információ, konkrét módszertan, valamint ellenőrizhető technológiai vagy üzleti állítás.
A konkrét, ellenőrizhető bizonyíték ember és automatizált rendszer számára is több értelmezhető információt ad, mint egy általános marketingállítás.
Accessibility
Kérdés: Technikailag hozzáférhető, feldolgozható és strukturált-e az információ?
Válasz: Ez az a technikai réteg, amely meghatározza, hogy a többi három réteg információi mennyire megbízhatóan hozzáférhetők és feldolgozhatók a gépek számára. Ide tartozik többek között:
- szemantikus HTML és következetes H1–H6 struktúra
- egyértelmű, leíró URL-struktúra
- belső linkelés jól leíró horgonyszöveggel
- canonical kezelés duplikált tartalomnál
- Organization, Service, Article és Breadcrumb típusú strukturált adat, a schema.org szabvány szerint
- látható szerzői és publikálási, frissítési információ
- egyértelmű márka- és entitásazonosítás az oldalon
- crawlability és indexálhatóság, tiszta robots.txt beállításokkal
- tudatos AI crawler policy
- olyan technikai megvalósítás, amelyben a kritikus tartalom nem függ szükségtelenül kliensoldali JavaScript-rendereléstől, és a releváns crawlerek számára megbízhatóan hozzáférhető
Ha ez a réteg gondatlan, a pozíciódat sokkal nehezebb értelmezni, függetlenül attól, mennyire pontos az Identity, a Structure vagy az Evidence réteg.
Ez a réteg nem látványos, mégis ez az alap, amin a másik három réteg egyáltalán olvashatóvá válik.
Ami az embernek marketingköd, az a gépnek besorolhatatlan zaj.
A leggyakoribb hibák
Négy hibával találkozunk a leggyakrabban, amikor egy cég elkezd a gépi olvashatósággal foglalkozni.
Az első, amikor valaki a machine experience-t egy újabb SEO-modulnak kezeli, amit rá lehet ragasztani egy amúgy is töredezett szerkezetre. Ha a szolgáltatások homályosak, ha duplikált oldalak versengenek egymással és a belső linkelés véletlenszerű, egyetlen új CMS-mező nem javítja meg a rendszert.
A második, amikor valaki kizárólag az AI-válaszoknak ír. Ez könnyen felfújt GYIK-blokkokhoz, túlzsúfolt sémajelöléshez és olyan szöveghez vezet, amely gépbarátnak tűnik, de egy embert kifáraszt. Az erős machine experience nem trükk, hanem tisztaság.
A harmadik, amikor egy cég stratégia nélkül tiltja le vagy engedi be a botforgalmat. Az AI-crawlerek kezelését tudatos láthatósági és tartalomvédelmi döntésként érdemes kezelni. Az egyes szolgáltatók eltérő botokat és felhasználási módokat alkalmazhatnak, ezért nem érdemes automatikusan mindent engedélyezni vagy mindent tiltani.
A negyedik a gazdátlan tartalom. Az AI-generált oldalak, a rég elfelejtett blogbejegyzések, a félbehagyott szolgáltatásoldalak és az egymásnak ellentmondó állítások halmaza nem bizalmat épít, hanem zajt termel. Egy gép ezt a zajt jellemzően felnagyítja, tiszta pozícióvá viszont nem tudja alakítani.
Mibe kerül, ha figyelmen kívül hagyod
A becsületes kérdés nem az, mibe kerül a machine experience kiépítése, hanem az, mibe kerül, ha egy weboldal 2026-ban is online van, de az új olvasói nem értik meg.
Láthatóságba kerül azokban a pillanatokban, amikor a felhasználók már nem a klasszikus módon keresnek. Bizalomba kerül, amikor egy AI-összefoglaló pontatlanul vagy túl általánosan írja le az ajánlatodat. Megkeresésekbe kerül, amikor az emberek nem látják, miért pont veled kellene beszélniük. És időbe kerül, mert minden értékesítési beszélgetés az alapoktól kezdődik újra, amiket a weboldalnak már régen tisztáznia kellett volna.
A gépi olvashatóság hiánya nem hangulatkeltés témája, hanem konkrét architektúra-kérdés. Azok a weboldalak, amelyek tisztán strukturáltak, nem csak az AI-rendszerekben nyernek, hanem az embereknek is jobbá válnak, világosabb navigációval, erősebb szolgáltatásoldalakkal és érthetőbb döntési logikával.
A gépi olvashatóság ára láthatatlan, a hiánya viszont számlázható.
Mit ért meg egy gép a weboldaladból? Egy gyors mini-audit
Az alábbi kérdésekkel gyorsan felmérheted, hol áll ma a saját weboldalad, az Identity, Structure, Evidence és Accessibility rétegek mentén.
Egyértelműen azonosítható, mivel foglalkozik a cég?
Kiderül, pontosan kinek szólnak a szolgáltatások?
A fontos szolgáltatások külön, egyértelmű URL-en szerepelnek?
Az állításokat referenciák, esettanulmányok, adatok vagy források támasztják alá?
Következetesen ugyanazt állítja a cég magáról minden fontos oldalon?
Egyértelmű a HTML- és címsorhierarchia?
Van logikus kapcsolat a probléma, a szolgáltatás, a bizonyíték és a kapcsolatfelvétel között?
Ha ezekre a kérdésekre több válasz is bizonytalan, azt érdemes egy alaposabb, teljes weboldalra kiterjedő átvilágítással feltárni.
Hogyan valósítjuk meg ezt a gyakorlatban
Az Identity, Structure, Evidence és Accessibility modell nálunk nem elmélet marad, hanem konkrét munkafolyamathoz kapcsolódik. A Strategy feltérképezi az Identity és a Structure réteget, vagyis hol törik meg ma a döntési logika a weboldaladon. A Creative az Evidence réteget építi fel, egyértelmű és bizonyítható kommunikációval, amely nem csak állít, hanem bizonyít is. A Development az Accessibility réteget valósítja meg, a semantic HTML-t, a structured data-t és a technikai olvashatóság alapjait, amit a gépek is megbízhatóan olvasnak. A Support pedig mind a négy réteget folyamatosan figyeli, monitoringgal, frissesség-ellenőrzéssel és optimalizálással, ahogy az AI-rendszerek és a keresési szokások tovább alakulnak.
Ha kíváncsi vagy rá, hogyan áll a saját weboldalad ezen a négy rétegen, szívesen végignézzük veled.
A következő években az a weboldal nyer, amelyet ember és gép egyaránt pontosan megért.